プロダクトエンジニアカンファレンス2026に参加しました

2026/09/05に東京で開かれたプロダクトエンジニアリングカンファレンス(略称PdEカンファレンス)に参加してきました。

プロダクトの価値について考えるエンジニアが集うイベントで、参加することが出来て大変有意義でした。 これまで余り東京のイベントには参加していませんでしたが、参加しに行って良かったと心から思っています。 自分もプロダクトの価値を追求できるように、より動いていきたいと考えを引き締めるようになりました。

参加した動機

まず一言で言うと、「プロダクトエンジニア」という心構えでこれから過ごしていきたいと考えているからです。

というのは、自分は元々「フルスタックエンジニア」もとい、全てを完璧には出来ないので1つに軸を置き、他の領域も担当する「マルチスタックエンジニア」を志して過ごしてきました。実際、バックエンドが主領域ですが、フロントエンドやインフラも必要に応じて携わっています。会社ではそうした気持ちを一括りにして、「Software Enginner」という肩書きを名乗っています。

一方で、それらの技術を通じて生み出すものは会社の利益につながっていく必要があります。どれだけ技術力が高い、いわゆるモダンな技術を使ったところで、ユーザーに使われ、利益につながらなければ、ただの自己満足に終わってしまいます。

自分自身は、自分の技術力の足りなさというところもあり、モダンな技術に触れることを志向していましたが、技術と「プロダクトの価値」について考えるようになったのがここ数年の新たな変化点ではありました。

そうした中、例えば仲の良い先輩や知り合いの方だったりが、プロダクトエンジニアというロールと知り、どういうものかなと思った時に「こうした方向性」というのが大事になるからこそ、新しい名称として生まれたのだと感じました。

実際「フルサイクルエンジニア」という名称のように単に作ってリリースするだけではなく、自分が作ったものがどう使われ、どう価値に影響し、その結果今後どうするか、といった一連の流れを知ることは重要で、技術を扱うのは必要最低限。むしろその技術をどう「活かすか」というのが求められていることだと痛感しています。

そしてそれは直近の生成AIの活用でも顕著で、「開発の時間は短くなった」ということを聞きますが、その一方で「じゃあどうするか」というところで、より事業にも染み出していく必要性が高まっていると感じています。

そしてそのこと自体は私は良いことだと考えており、元々別領域で働いていたバックグラウンドもあるし、かつ「なぜその機能を作りたいのか」といった考えを知ることで、自分自身ももっと良いものづくりが出来ると考えているからです。

・・・というあたりのことを直近考えていたこともあり、「プロダクトエンジニア」が集まるカンファレンスに行ってみようと参加した次第でした。

参加してみて

期待以上のイベントでした!

自分が日頃から考えていたようなことを話してもらう場もあれば、「いや〜そうだよな」「確かに」と思いながらセッションの話に引き込まれていました。

例えば招待講演のデジタル庁の話を聞いて、これまで自分は「プロダクトを通じてユーザーにどうなってもらいたいのか」といったことを考えることは出来てなかったなと思いました。話の文脈としては引越し手続きの話でしたが、引越し手続きをしたいんじゃなくって引っ越ししたから手続きを「しないといけない」という例を踏まえて語られました。この辺りは自分も話を聞きながら考えるきっかけをもらえました。 AIでこれまでよりも開発スピードが速くなる昨今、プロダクト開発で大事なところは何か?を見極める必要性というところで、いわゆるPdMの方な考え方もより重要になるなと感じました。

ちなみに、以下のセッションを聴講しました(本当であれば詳細に感想をそれぞれ書きたいのですが、一旦タイトルのみで・・・)。

  • エンジニアリングは、どこまで拡大解釈できるか 心技体をつないだままで事業責任者になった話
  • プラチナスポンサー様のセッション(mento社、タイミー社、リンクアンドモチベーション社、RightTouch社)
  • AI時代に、プロダクトの数だけ積み上がる所有コストをどうエンジニアリングするか
  • KPIだけでは運用できないプロダクトが考えるべき「Evals」という第2の評価系
  • クロスボーダーM&AのValue Upを支えるプロダクト開発。日米チームのハブになったプロダクトエンジニアの実践
  • AIで実装は速くなった。なのにプロダクトは速くならない。職能の壁を越えて価値のフローを設計する
  • 作り直せるコードは迅速に、作り直せないDBは慎重に — AI時代のプロダクトエンジニアが「判断の不可逆性」で開発速度を変える話

全体的な話を通じて、AIを活用するのはもう「前提」として各社下地があり、その上でどうしていくのか、と言うことに目が向いているんだなと改めて痛感しました。

単に技術力を提供するだけでは今後生き残れないと切に感じたので、今できることをより増やしていく必要性を新たに抱きました。繰り返しですが、自分自身は職能を超える、といったところは抵抗感がなく、むしろそうした動きの方があっているんだろうと考えているので、求められる役割に乗っていけるように取り組んでいきたいです。

とはいえ、技術力の重要性ということも引き続き変わらないので、技術から逃げないようにな、と自分自身に圧を掛けているところです。

余談

元々SNS上で繋がりのあったエンジニアの方や、先日の、きのこ関西で知り合うことの出来た方、初めましての方など多数の方とお話しすることが出来ました。

懇親会でたくさんお話しできたと思う一方で、まだお話足りてないと思う気持ちもあるので、また何かの折に色々な方とお話しできるタイミングを作っていきたいなと感じています。

ということで、最初から最後まで楽しいイベントでした。次参加するときは、また違う目線になれているようにと祈りつつ、一度キーボードから手を離すことにします。

生成AIと理解について

最近職場で生成AIをどう使うか話す機会が増えました。そこで今の自分が考えていることを自分なりに書いてみます。

結論

生成AIが出る以前より、自分の頭で考えることの重要性が高まったと考えています。 これは以前だとブログを読んだりリファレンスを読んだりして考える機会が得られやすかったけど、そういう機会も減ってしまい考えずにできるようになったからだと捉えています。

最近の個人開発で感じたこと

私は最近、久しぶりに個人でアプリケーション開発をしています。普段はPythonを扱うことが多かったですが、この前の休みに心機一転Rustを学習しようと思いRust製のアプリケーションを開発しています。また、直近の開発にはもっぱらCodexを利用しています。 Codexを使えば、コードを読み挙動を理解する時間を取らなくても開発を進められます。だからこそ、意識的にコードを読んで理解する時間を作る必要があります。

そうしないと自分が理解していないままアプリケーションが出来上がります。

必要な理解の深さは目的によって変わる

しかし、完全に理解せよと論じようとは思っていなくて。例えば目的が「公開する事」なら、スピードを優先して実装してもらうことは意味があると思っています。一方で「学習」が目的ならRustの所有権とは、借用とは、といったことを腹落ちしないまま進めてしまうと、「あれ結局何?」となった時、自分がちゃんと扱えません。

ただ、学習の深さについてもどこまで理解するかと言う問題も付き纏うと思っています。例えばPythonはガベージコレクションの仕組みを詳しく知らなくても使えますが、メモリ管理を学んだ人からすると、理解の浅い使い方に映るかもしれません。

このことを考えると、「自分が今やろうとしていることに対して、どこまで何が理解が必要なのか」といったことを自分で考える必要があります。

AIに任せる役割を自分の理解に応じて変える

全てのタスクを何も考えずに「これやって」と生成AIに依頼すると、そこに対して良し悪しを判断できない状態になるなと感じています。

私は生成AIに対しては一定の信頼を置いていますが、出力を無条件に信用していません。そのため、生成AIの出力の良し悪しを評価する軸を自分なりに持つ必要があると考えています。

そのため、自分が知っている領域では後からリカバリも効かせやすいので適当に指示してもどうにかなりやすい一方、知らない領域で成果物をいきなり作らせると自分自身が良し悪しを判断できないため、混乱することもあるなと感じています。そこでは例えばChatGPTだと勉強モードであったり、まず調査からさせたり、といったことを行うことで理解を深めるようにしています。

よく見聞きする自分の中で浮かんでいること

t_wadaさんがよくAIは「増幅器」だと言っていることが印象に強く残っています。

AIは知識の代替ではなく増幅器なのです。これが非常に重要です。私はよく公の場で「労力は外注できるが、能力は外注できない」と言っています。

https://findy-code.io/media/articles/event-twada-250514

自分でもPythonのことはグッと伸ばせる感覚はあるし、知らないことを同じようにやろうとすると「あれこれで良いんだっけ?」となることが多いなと感じています。となるとやっぱりエンジニア個人の能力を伸ばすのが第一だなと身につまされます。

また、新原さんの記事が今回特に刺さった記事でした。

https://blog.shin1x1.com/entry/dont-let-go-of-understanding

この記事を読んだこともあり、理解についての自分なりの記事を書こうと思って書きました。

個人的に焦ると生成AIの出力に飛びつきたくなる気持ちがありますが、そう言う時こそグッと堪えて理解には時間がかかるのだ、と一呼吸置くようにしています。ここで飛びつくか否かが今後の自分を助けてくれるのだろうと思いながら。

と言いつつ試行錯誤の途中

書いていて自分なりの向き合い方を改めて言語化できたかなと思っています。時に振り回されそうになりつつ、適切に生成AIに対してマネジメントできるようになる必要がありますね。

と言うわけで、必要なところで理解を手放さないよう努めていきます。

1Passwordのアイコンを特定の入力欄だけ非表示にする

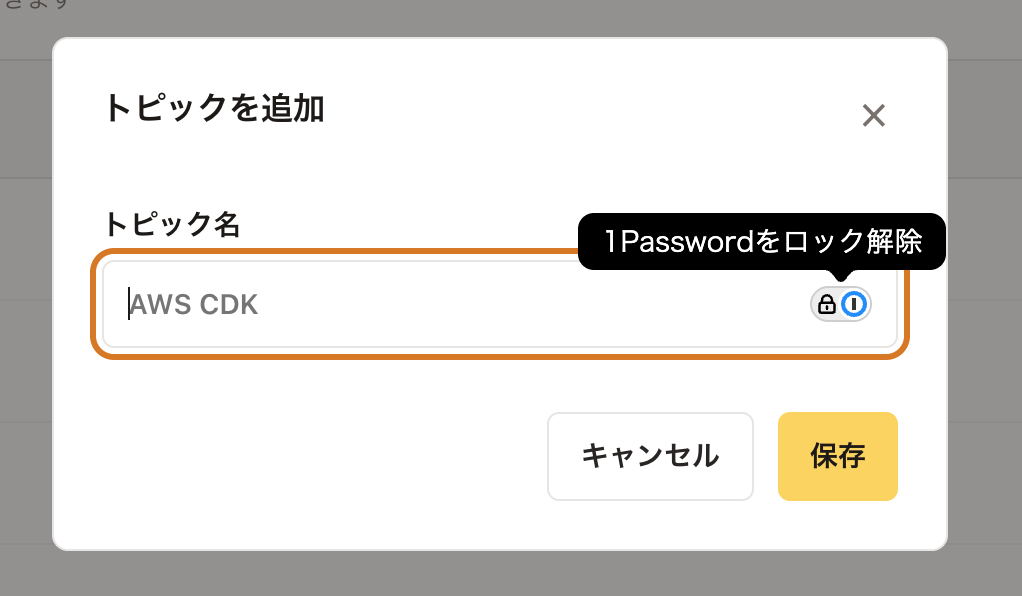
開発をしていて、通常のテキスト入力欄(inputタグ)で1Passwordのフィールド右端にアイコンが表示されることがありました。別にpassword入力をしないのに表示されるのは非常にnoisyでした。

以下のような感じですね。

そこで1Password公式ドキュメントで案内されているdata-1p-ignoreを追加しました。

具体的には以下のように指定します。

<input
  type="text"
  name="name"
  autocomplete="off"
  data-1p-ignore
>

これにより1Passwordの機能全体を無効にせず、指定したフィールドだけを自動入力の対象外にできます。

余談ですが、今開発しているものはRustのMaudを使っているため、実装は次のようになりました。

input #topicName name="name" type="text" maxlength="80"
      autocomplete="off" data-1p-ignore
      placeholder="AWS CDK" required;

参考:Design your website to work best with 1Password (https://www.1password.dev/web/compatible-website-design)

夏休みをふりかえる

8/8(土)~8/16(日) まで9連休を取得していたので、一度やったことを軽くふりかえっておきます。元々こんなに休むつもりはありませんでしたが、8/10(月) も休んだら?と言われたこともあり、かつ妻も休みだったのでまとめて休むことにしました。

結論

まとまった休みは必要だなと改めて思いました。個人的には今回休んでみて、5日間は休みを取る方が良いなと思ったので、これからも機を見てしっかり休みを取っていきたいと考えています。

(なんて幼い感想なんだ・・・)

やったこと

すごくざっくりレベルで書いてみます。

  • 1日目
    • この日は何を勉強しようかなと思いながら過ごしていたはず。リアルタイム文字起こしとかどうかな〜と考えて調べていた
    • 圕の大魔術師を通読した
  • 2日目
  • 3日目
  • 4日目
  • 5日目
    • 書いた記事
    • https://nibutan.hatenablog.com/entry/2026/08/12/061935
    • https://nibutan.hatenablog.com/entry/2026/08/12/113827
    • ブログをいい感じに小さい粒度にできて書け始めた感
    • 初めて副業の面談依頼をもらったけど、今あまりキャパがないので面談自体を断った
    • これでよかったのかなとはちょっと思っている(次はちゃんと話できるようにしておきたい)
    • 名古屋のボルダリングジムに行って派手にパンプする
    • その後会社の東海勢の人たちと飲み会に行ってはしゃいだ
  • 6日目
    • ボルダリングに関連してMediaPipeで自分の動きをちょっと解析したり、持ち手の探索をするアプリを作ってみてみていた
    • https://nibutan.hatenablog.com/entry/2026/08/13/105431 を書いた
    • 文字起こしツールにPyObjcを導入していい感じのデザインになってきた
    • ECS + FargateでRustのTODOアプリを導入しようと思い始めた
  • 7日目
    • AIに対してデザインシステムが必要だな、とかHTMLで共有してもらえる仕組みが必要だなと思い始めていた
    • Cloudflareを使って個人開発も楽しそうだなとみていた
    • https://nibutan.hatenablog.com/entry/2026/08/14/053226 を書いた
    • ボルダリングのアプリ難しいなと悩んでいた
    • 地元の親友が急に電話をかけてきたと思ったら、10年間連絡がついてなかった(正確には本当に連絡がつかなかったのは数年単位だが)友人と一緒に過ごしていたようだった。久しぶりに話せれて楽しかった
    • Swiftでちょっと作りたいアプリを作ることができた(作って分かった意図と違う挙動もあった)
    • ドメインを数年ぶりに取得した
    • この辺りから開発がすごく楽しくなってきていた
  • 8日目
    • 書いた記事
    • https://nibutan.hatenablog.com/entry/2026/08/15/064248
    • 妻と映画ちいかわを観に行ってたら義父から連絡あり。ただ機内モードなので出れなかったら、私に電話が通じないのは異常事態と思った義父大慌てで笑った
    • その後、温泉に連れて行ってもらって過ごした。実はこれで3日連続実家で食事をしていた。ありがたし・・・
  • 9日目
    • 今日は今の記事を書いていた

読んだ本

ちなみに休暇なので本も読みたいと思い、色々読んでいました。以下の本をガッと読みました(読みかけもあります)。

雑感諸々

この休みの目標は以下あたりを考えていました。

  • ゆっくり休む
  • 休み方を学ぶ
  • 中長期的な目標を一度考える
  • 最近キャッチアップできてなかったAI周りのところ抑える
  • この2ヶ月学んだことをアウトプットする

それぞれ、一応できたかなとは思っています。

やっぱり1日目、2日目の内容を見直すと明らかにやれてたことが少なそうなので、まず休むことはできたかなと。そして休み方を学ぶについては、整理しきれてないですが色々と調べて改めて学べたかなと思っています。

https://www.youtube.com/watch?v=qCSHVD5Sl18 辺りが特によかったかなと思っています。

雑感なので取り留めないままかくと、AI周りについては良いところ悪いところも改めて腹落ちしてきて、同じようなことは誰かしら考えているからGitHubを調べるなど手法あるなーと思いました。自分としてはUI/UX周りのことや、要件を整理するようなスキルが必要だなとAIの苦手なところを自分でできるようにする必要があるかな、と思ったりもしています。

そして中長期的な目標なんですが、これが考えているけどなかなか浮かばない。ここについては引き続き模索というか、そもそもどういう選択肢があるんだっけ?を知るところが必要なのかなと思っています。

ただ目標として今後どうしていきたいか、は少しずつ固まってきた感があるので、その方向へ舵を取れるようにやっていきたいですね。

あとは生成AIを並列で4〜5個くらい思ったことを色々やらせていると、そりゃ大変だよなと改めて思ったので、せめて余暇はAIを使って浮いた時間はご自愛の方向に舵を取るのも大事かな、なんて分かったような分かってないようなことを書いて記事を終わらせます。

Powertoolsでタイムアウト後に処理を再実行する

Powertoolsでは処理を実行する前にDynamoDBにstatus=INPROGRESSを保存することは見てきました。

今回は異常系の別ケースとしてstatus=INPROGRESS保存後にLambdaがタイムアウトした場合どうなるのかを整理します。

ここではin_progress_expirationという、処理中にレコードが期限切れになったかどうかを扱う値が関係してきます。

全体の流れ

今回は以下のようになります。

sequenceDiagram
    participant S as SQS
    participant L as Lambda
    participant P as Powertools
    participant D as DynamoDB

    S->>L: job_id=job-001
    L->>P: process_job(job)
    P->>D: INPROGRESSと<br/>in_progress_expirationを保存
    P->>L: 業務処理を実行
    L--xL: タイムアウト
    Note over D: INPROGRESSが残る

    Note over S,D: in_progress_expirationを過ぎた後

    S->>L: 同じjob_idを再配信
    L->>P: process_job(job)
    P->>D: 既存レコードを確認
    D-->>P: INPROGRESSと<br/>in_progress_expiration
    P->>P: 処理中の期限切れと判断
    P->>L: 業務処理を再実行

in_progress_expirationについて

冒頭に書いたように、INPROGRESSの状態でLambdaがタイムアウトするとレコードは残ったままになります。

そこでどうするかというと、in_progress_expirationという現在時刻を基にしたLambdaの残り実行時間を加えたミリ秒単位のUnix時刻が入る属性を利用します。この時刻を過ぎたあとは期限切れとして扱います。これによって、期限切れ以降は同じ冪等性キーを受け取った場合にも処理を再実行できるようになっています。

Powertools内部の処理を確認すると、主要部分は次のようになっていました。

if remaining_time_in_millis is not None:
    now = datetime.datetime.now()
    period = datetime.timedelta(milliseconds=remaining_time_in_millis)
    timestamp = (now + period).timestamp()
    data_record.in_progress_expiry_timestamp = int(timestamp * 1000)

save_success より

Lambdaの残り実行時間を現在時刻に加え、最後に1000倍することでミリ秒単位のUnix時刻にしています。data_record.in_progress_expiry_timestampはPowertools内部の変数で、この値がDynamoDBのin_progress_expiration属性へ保存されます。

Lambda Contextの登録

実際に登録する場合、一例としては次のように登録するようでした。

def lambda_handler(event: dict[str, object], context: LambdaContext) -> None:
    config.register_lambda_context(context)

LambdaContextにはいくつかメソッドがあり、その1つのget_remaining_time_in_millis()からタイムアウトまでの残り時間を取得するようでした。

あとはLambdaの処理をタイムアウトするように実装を行い、動かしてみます。 処理の内容は割愛しますが、1回目のLambda受信の際に10秒待つ処理を書き、Lambda作成時のAWS CDKにはtimeout=Duration.seconds(5)を設定して、タイムアウトするようにしています。

2回目の処理の時には10秒待つ処理が動かないようにし、2回目は意図通り成功することを確認します。

動作を確認する

以下のようにしてメッセージを1件送ります。

aws sqs send-message \
  --queue-url "$QUEUE_URL" \
  --message-body '{"job_id":"timeout-001"}' \
  --region ap-northeast-1

DynamoDBを確認して、タイムアウトのレコードが残ったままであることを確認します。

aws dynamodb scan \
  --table-name "$TABLE_NAME" \
  --region ap-northeast-1

実行結果

2026年8月15日にap-northeast-1で確認しました。ログの時刻はUTCです。

job_id=timeout-20260815-001
message_id=9ae02eab-a1b0-46c6-8a91-23dcd1a0040d

20:49:59.855 START
  lambda_request_id=ba0e7635-0ffb-5a71-bc36-14cc8e569164

20:49:59.982 receive_count=1 business_operation_started
  lambda_request_id=ba0e7635-0ffb-5a71-bc36-14cc8e569164

20:50:04.864 Duration=5000.00 ms Status=timeout
  lambda_request_id=ba0e7635-0ffb-5a71-bc36-14cc8e569164

1回目のLambdaがタイムアウトしたあと、DynamoDBを確認すると次のようになっていました。要点だけ抜き出します。

{
  "status": {
    "S": "INPROGRESS"
  },
  "in_progress_expiration": {
    "N": "1786740604855"
  }
}

in_progress_expirationを日本時間に変換すると2026年8月15日05:50:04.855で、Lambdaの実行開始は05:49:59.855だったため、ちょうど5秒後の時刻が保存されていることを確認できました。

その後、同じSQSメッセージの再配信を確認します。

20:50:59.702 receive_count=2 business_operation_started
  lambda_request_id=d88d7b27-8c38-52c2-9499-19de0dd1c050

20:50:59.703 receive_count=2 business_operation_executed
  lambda_request_id=d88d7b27-8c38-52c2-9499-19de0dd1c050

2回目の処理後、DynamoDBは次のように更新されました。

{
  "status": {
    "S": "COMPLETED"
  },
  "data": {
    "S": "{\"execution_id\": \"ecff4c35-016a-4e9c-9b58-fd5587e3f450\", \"job_id\": \"timeout-20260815-001\", \"replayed\": false}"
  }
}

in_progress_expirationを過ぎたあとに同じ冪等性キーを受け取ったため、2回目は処理が実行されたことを確認できました。

Powertoolsで処理中の重複実行を防ぐ

前回のPowertoolsを利用してLambdaの冪等性を実装するでは触れなかった、1回目の処理実行中のタイミングで同じ冪等性キーを持つメッセージを受け取った場合の挙動を確認します。

全体の流れ

流れは以下のようになります。

sequenceDiagram
    participant S as SQS
    participant L1 as Lambda 1回目
    participant L2 as Lambda 2回目
    participant P as Powertools
    participant D as DynamoDB

    S->>L1: job_id=job-001
    L1->>P: process_job(job)
    P->>D: status=INPROGRESSを保存
    P->>L1: 業務処理を実行

    S->>L2: 同じjob_id=job-001
    L2->>P: process_job(job)
    P->>D: 既存レコードを確認
    D-->>P: status=INPROGRESS
    P--xL2: IdempotencyAlreadyInProgressError

process_job(job)というのは今回用意した動作検証用の処理を指します。

IdempotencyAlreadyInProgressErrorの発生

Powertoolsは、最初の処理でDynamoDBにstatus=INPROGRESSを保存してから業務処理を実行します。

この状態で同じ冪等性キーを持つメッセージを受け取ると、PowertoolsはIdempotencyAlreadyInProgressErrorを発生させます。

これによって、同じ処理が同時に実行されることを防ぎます。

This utility will raise an IdempotencyAlreadyInProgressError exception if you receive multiple invocations with the same payload while the first invocation hasn't completed yet.

参考: Handling concurrent executions with the same payload

実装する

処理中の重複を発生させるため検証用の待ち時間を入れます。主要部分のみ抜粋します。

import time


def run_business_operation(job: dict[str, str]) -> dict[str, str]:
    logger.info(
        "business operation started",
        extra={
            "event": "business_operation_started",
            "job_id": job["job_id"],
        },
    )

    time.sleep(5)

    logger.info(
        "business operation executed",
        extra={
            "event": "business_operation_executed",
            "job_id": job["job_id"],
        },
    )
    return {"job_id": job["job_id"]}

この関数にidempotent_functionデコレータを付与し、job_idを冪等性キーにします。

@idempotent_function(
    data_keyword_argument="job",
    persistence_store=persistence_layer,
    config=config,
)
def process_job(job: dict[str, str]) -> dict[str, str]:
    return run_business_operation(job)

例外自体はPowertoolsが発生させるので、以下のようにexceptで捕捉します。

try:
    process_job(job=job)
except IdempotencyAlreadyInProgressError:
    logger.warning(
        "same idempotency key is already being processed",
        extra={"event": "duplicate_in_progress"},
    )
    raise

実際に発生させてみる

Event Source Mappingのバッチサイズを1件にし、同じjob_idを持つメッセージを2件まとめて送ります。

JOB_ID="in-progress-$(date +%s)"

aws sqs send-message-batch \
  --queue-url "$QUEUE_URL" \
  --entries "[\
    {\"Id\":\"first\",\"MessageBody\":\"{\\\"job_id\\\":\\\"$JOB_ID\\\"}\"},\
    {\"Id\":\"second\",\"MessageBody\":\"{\\\"job_id\\\":\\\"$JOB_ID\\\"}\"}\
  ]" \
  --region ap-northeast-1

実測結果

2026年8月14日にap-northeast-1で実行しました。

1件目 message_id=73b22a99-9e58-47de-883e-4fd886fc2749
2件目 message_id=ff887b7b-e389-4dfd-a102-0ddebc5f3394

Worker Lambdaのログは次のようになりました。時刻はUTCです。

20:17:21.699 event=business_operation_started
  message_id=73b22a99-9e58-47de-883e-4fd886fc2749
  lambda_request_id=55d259e1-447e-5e11-a6d3-3b196cfdbd6d

20:17:21.720 event=duplicate_in_progress
  message_id=ff887b7b-e389-4dfd-a102-0ddebc5f3394
  lambda_request_id=ea5de905-184a-521e-bf34-8bfd30c95bee

[ERROR] IdempotencyAlreadyInProgressError:
Execution already in progress with idempotency key: ...

20:17:26.700 event=business_operation_executed
  message_id=73b22a99-9e58-47de-883e-4fd886fc2749
  lambda_request_id=55d259e1-447e-5e11-a6d3-3b196cfdbd6d

business_operation_startedが最初にログに出力され、次にduplicate_in_progressが出ていること、そしてIdempotencyAlreadyInProgressErrorが意図通り出力されていることが確認できました。Powertoolsは恐らく開発の知見が溜まっているんだな、と色々と思わされます。

Powertoolsを利用してLambdaの冪等性を実装する

Lambdaで冪等性を担保する方法として、AWS re:PostにPowertools for AWS Lambdaを使った方法が紹介されています。

参考: Lambda 関数を冪等にする方法を教えてください。

上記の記事を参考にして冪等性担保について学ぶことにします。

使うもの

以下を今回は利用します。

  • Powertools for AWS Lambda (Python)
  • Amazon SQS
  • AWS Lambda
  • Amazon DynamoDB

SQSは再配信される可能性があるため、SQSで再配信したとしてもLambdaで同じ処理を再実行しないようにします。

Powertoolsについて

PowertoolsのIdempotencyユーティリティを使うと同じ冪等性キーで処理済みの場合、処理を再実行せずに保存済みの結果を返せます。

今回は処理を識別するため、SQSメッセージにjob_idを用意して、job_idを冪等性キーとして処理状態をDynamoDBへ保存します。

AWS公式資料: Powertools for AWS Lambda (Python) - Idempotency

全体の流れ

以下のような図になります。

sequenceDiagram
    participant S as SQS
    participant W as Worker Lambda
    participant P as Powertools Idempotency
    participant D as DynamoDB
    participant B as 業務処理

    S->>W: ① job_id=job-001を受信
    W->>P: ① job_idを抽出
    P->>D: ②③ status=INPROGRESSを条件付き保存
    P->>B: 業務処理を実行
    B-->>P: 成功
    P->>D: ④ status=COMPLETEDと処理結果を保存
    P-->>W: ⑤ 正常終了

    Note over S,D: 同じjob_idをもう一度受信

    S->>W: ① job_id=job-001を受信
    W->>P: ① 同じjob_idを抽出
    P->>D: ② 既存レコードを確認
    D-->>P: status=COMPLETEDと処理結果
    P-->>W: 保存済みの結果を返す
    Note over P,B: 業務処理は実行しない

以下、re:Postの「べき等 Lambda 関数ロジックの例」の内容を理解するために一度整理します(原文を若干変更して書いています)。

① イベントの一意の属性の値を抽出

SQSメッセージのjob_idを今回は一意の属性の値として扱います。

{
  "job_id": "job-001"
}

② 条件式を使用してDynamoDBに保存する

条件式とは、DynamoDBのPutItemやUpdateItemで、条件を満たす場合にだけ書き込むための式です。

PowertoolsのIdempotencyユーティリティはこの条件式を利用し、冪等性キーが存在しない場合のみ保存します。

反対に、冪等性キーが既に存在する場合はPowertools側で既存レコードを確認し、処理が完了していれば保存済みの結果を返します。

③ レコード属性に対してアクションを実行

最初の処理では、DynamoDBへstatus=INPROGRESSを保存してから業務処理を実行します。

先に処理中として保存することで、同じjob_idの処理が重複して実行されることを防ぎます。

④ ステータスを更新する

業務処理が成功すると、DynamoDBへstatus=COMPLETEDと処理結果を保存します。

⑤ アクションを完了

DynamoDBへの処理結果の保存まで完了すると、Lambdaは正常終了します。

なおINPROGRESSの間に同じjob_idを受け取った場合、まだ返せる処理結果がないためPowertoolsはIdempotencyAlreadyInProgressErrorを発生させます。

今回はCOMPLETEDになった後の重複だけを確認します。

AWS公式資料: Powertools for AWS Lambda (Python) - Handling concurrent executions with the same payload

実装内容

まず、AWS CDKで冪等性レコードを保存するDynamoDBテーブルとWorker Lambdaを作ります。

主要部分のみ抜粋します。SQSやLogGroupなどは省略しています。

idempotency_table = dynamodb.Table(
    self,
    "IdempotencyTable",
    partition_key=dynamodb.Attribute(
        name="id",
        type=dynamodb.AttributeType.STRING,
    ),
    billing_mode=dynamodb.BillingMode.PAY_PER_REQUEST,  # 読み書きした分だけ支払う
    time_to_live_attribute="expiration",  # TTLの設定 今回はexpiration属性を使うことで、古いレコードを自動削除する
    removal_policy=RemovalPolicy.DESTROY,  # cdk destroyで削除する場合にテーブルも削除する
)

worker_function = lambda_.Function(
    self,
    "WorkerFunction",
    runtime=lambda_.Runtime.PYTHON_3_13,
    handler="handler.lambda_handler",
    code=lambda_.Code.from_asset(...),
    environment={"IDEMPOTENCY_TABLE": idempotency_table.table_name},
)

# grant_read_write_data でLambdaからDynamoDBへの読み書き権限を付与する
idempotency_table.grant_read_write_data(worker_function)

※code=lambda_.Code.from_asset(...)では、handler.pyとPowertoolsなどの依存ライブラリをLambdaへ配置する箇所ですが、割愛するため(...)のように書いています。

# DynamoDBPersistenceLayerはPowertoolsが冪等性レコードをDynamoDBに保存するためのクラス
persistence_layer = DynamoDBPersistenceLayer(
    table_name=os.environ["IDEMPOTENCY_TABLE"],
)
# event_key_jmespath で、job_idを冪等性キーとして使うことを指定
config = IdempotencyConfig(
    event_key_jmespath="job_id",
)


# data_keyword_argumentで、引数のjobを冪等性判定の対象に設定
@idempotent_function(
    data_keyword_argument="job",
    persistence_store=persistence_layer,
    config=config,
)
def process_job(job: dict[str, str]) -> dict[str, object]:
    return run_business_operation(job)

Worker Lambdaでは、SQSメッセージ1件の処理をidempotent_functionで囲みます。

run_business_operationは、業務処理に見立てた関数です。

実行されたことを確認するため、実行ごとにbusiness_operation_executedというログとexecution_idを作ります。

data_keyword_argumentに指定したjob(実態はjob_id)を取り出し、冪等性キーとして使います。

実践内容

同じjob_idのメッセージを2回送りWorker LambdaのログとDynamoDBを確認します。

デプロイ

対象のAWSアカウントとリージョンを確認してからデプロイします。

uv sync --extra dev
aws sts get-caller-identity
aws configure get region
uv run -- npx --yes aws-cdk@2 deploy --outputs-file cdk-outputs.json

--outputs-fileで、AWS CDKの出力値をcdk-outputs.jsonへ保存しています。次のコマンドで、メッセージの送信先、DynamoDBのテーブル名、Worker LambdaのLogGroup名を取得します。

# SQSメッセージの送信先
QUEUE_URL=$(python -c 'import json; print(json.load(open("cdk-outputs.json"))["LambdaIdempotencyStack"]["QueueUrl"])')

# 冪等性レコードを確認するDynamoDBテーブル
TABLE_NAME=$(python -c 'import json; print(json.load(open("cdk-outputs.json"))["LambdaIdempotencyStack"]["IdempotencyTableName"])')

# Worker Lambdaのログ出力先
LOG_GROUP=$(python -c 'import json; print(json.load(open("cdk-outputs.json"))["LambdaIdempotencyStack"]["WorkerLogGroupName"])')

1回目のメッセージを送ります。

aws sqs send-message \
  --queue-url "$QUEUE_URL" \
  --message-body '{"job_id":"job-001"}'

aws logs tail "$LOG_GROUP" --since 5m --format short

business_operation_executedを確認したら、同じjob_idでもう一度送ります。

aws sqs send-message \
  --queue-url "$QUEUE_URL" \
  --message-body '{"job_id":"job-001"}'

aws logs tail "$LOG_GROUP" --since 5m --format short

DynamoDBのレコードも確認します。

aws dynamodb scan \
  --table-name "$TABLE_NAME" \
  --projection-expression "id,#status" \
  --expression-attribute-names '{"#status":"status"}'

実測結果

2026年8月13日にap-northeast-1で実行しました。

同じjob_idを持つ、別々のSQSメッセージを2回送りました。

job_id=idempotency-20260813-002
1回目 message_id=e01a4092-37ff-4d12-aaf8-e7976086e641
2回目 message_id=853c0f20-4df0-4134-ab6e-0fe46e9fe056

message_idは、SQSがメッセージごとに付ける識別子です。

AWS公式資料: Amazon SQSメッセージイベントの例

Worker Lambdaのログは次のようになりました。

1回目 event=business_operation_executed job_id=idempotency-20260813-002 execution_id=dde5996a-810a-47b3-b952-ba1d43407326
2回目 event=job_skipped job_id=idempotency-20260813-002 sqs_message_id=853c0f20-4df0-4134-ab6e-0fe46e9fe056

1回目はbusiness_operation_executedが出ました。

2回目はjob_skippedが出て、business_operation_executedは増えませんでした(今回省略したログ出力の処理の中に、スキップする処理を仕込んでいました)。

DynamoDBには、1回目の処理結果が保存されていました。

status=COMPLETED
job_id=idempotency-20260813-002
execution_id=dde5996a-810a-47b3-b952-ba1d43407326

同じjob_idを持つ別々のSQSメッセージを2回送っても、業務処理は1回だけ実行されることを確認できました。